月度生产会上,设备主管和生产主管又吵起来了。生产说上月停机 86 个小时,耽误了两个大单;设备说那 86 小时里一大半在等你们的排产窗口,真抢修只有二十来个小时。谁都对,谁也说不服谁——因为「停机损失」这个词,两个人脑子里是两套算法。多数制造企业的设备维保困在同一个地方:不是不想改善,是连「病有多重」都量不准。这篇就把口径、指标和落地路径一次讲透。
一、为什么你的停机损失永远算不清
算不清的原因通常不是数学问题,而是三件基础没做。认清这三件事,后面的指标才立得住。
1. 故障没有统一定义
操作工口头的「机器不对劲」、机修眼里的「小毛病」、生产统计的「停机事件」,三种口径各记各的账。同一台设备一个月「坏了」三次还是七次,取决于你问谁。指标体系的第一块砖,是把「故障」定义为:造成计划外停机、需要维修介入的事件。瞬时报警复位不算,调味不用维修的短停单列。
2. 时间戳靠回忆补
停机从几点到几点,月底凭记忆补记,误差以小时计。MTBF、MTTR 这些指标全部依赖时间戳,源头数据失真,算出来的指标就是「精确的错误」。这就是为什么维保数据化的第一步永远是扫码报修——接单、开工、验收每个节点自动打时间。
3. 损失只算了维修费
真正的停机损失 = 停机时长 × 单位时间产值贡献 + 废品损失 + 加班赶工成本 + 可能的延期赔付。只算维修费的公司,会系统性地低估停机的严重性,也就舍不得在预防性维护上投入。
二、两个指标,各管一件事
维保体系的技术骨架就两个指标:MTBF 和 MTTR。分开看很简单,用对不容易。
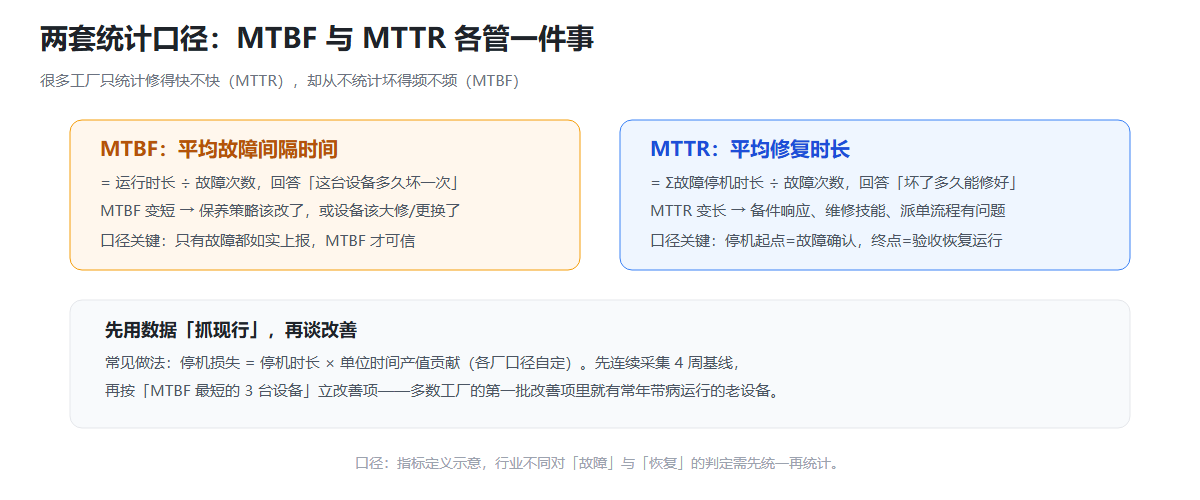
1. MTBF:平均故障间隔时间
等于运行时长除以故障次数,回答「这台设备多久坏一次」。MTBF 持续变短,说明保养策略失效或设备进入寿命末期,该大修还是该换,数据摆在那里。
2. MTTR:平均修复时长
等于故障停机总时长除以故障次数,回答「坏了多久能修好」。MTTR 居高不下,问题多半不在机修手艺,而在备件找不到、外协响应慢、审批链条长这些流程环节。
3. 两个指标必须一起看
只优化 MTTR 是「坏了快点修」,一起优化才是「少坏、坏了快修」。一台 MTBF 只有几十小时的设备,MTTR 修到极致也是赔钱货——这层关系,靠经验判断很难服众,靠数据一眼见底。
三、四步闭环:从数据采集到改善落地
指标定了,落地按四步走,一步都省不掉。
1. 第一步:统一口径(第 1 周)
和机修班组长开一次口径会,白纸黑字定义三件事:什么算故障、停机从哪个时间点起算(建议故障确认时刻)、恢复到哪个时间点截止(验收通过时刻)。口径不统一,后面全白干。
2. 第二步:连续采集基线(第 2~5 周)
所有报修走扫码工单,时间戳自动生成,连续采集 4 周,不加任何考核、不改任何流程——先让数据反映真实,再谈改善。加压力的时机不对,一线学会的第一件事是瞒报。
3. 第三步:排序找靶子(第 6 周)
拉出设备 MTBF 排行榜,锁定最短的三台。经验上,这三台往往贡献了全厂近三成的故障工单(多家制造企业基线统计的普遍现象),治好它们,指标就好看一半。
4. 第四步:立改善项并验证(第 7 周起)
每台靶子设备立改善项:是保养周期错了,还是点检漏项,还是备件更换策略太粗?改善动作执行后,继续用 MTBF 验证效果,两三个月一个周期滚动推进。
四、从 MTBF 排行榜里能读出什么
排行榜不是用来问责的,是用来定位三类典型问题的。
| 数据特征 | 典型根因 | 改善方向 |
|---|---|---|
| MTBF 短且故障集中同一部位 | 保养策略与实际工况不匹配 | 调整保养周期与项目,升一级保养 |
| MTTR 长且卡在备件等待 | 备件库存策略缺失 | 按更换频次设安全库存与预警 |
| 服役超 8 年且维修费走高 | 设备进入寿命末期 | 算总账:维修费+停机损失 vs 更新 |
一家做汽车饰件注塑的企业按这个路径走了两个季度,重复故障率降约五成、非计划停机时长降约三成(该企业 6 个月维保数据对比口径)。最意外的收获是机修班组态度的转变——以前绩效靠印象,现在响应时长、一次修复率都有据可查,老师傅反而成了数据最大的受益者。
五、三分技术,七分机制
最后说三句实话,比工具更重要。
- 先采集后考核:基线期承诺「数据不用于追责」,否则收到的是艺术创作不是数据;
- 榜单不点名批评:MTBF 排行榜用来找设备问题,不是找人的麻烦,一旦变成批斗榜,数据质量立刻崩;
- 指标看趋势不看单点:单月 MTBF 波动正常,连续三个月的趋势才有决策价值。
工具层面,这套体系不挑平台:关键是报修、点巡检、保养记录落在同一套设备管理与点巡检系统里,时间戳和故障数据天然打通,报表不用人拼。动手顺序建议从设备管理解决方案的工单模块起步,先把 MTBF、MTTR 两张榜跑起来,其他都是后话。
六、指标落进报表和考核的正确姿势
最后补一段实操里被问得最多的问题:指标算出来了,怎么变成报表和考核?这里面的门道不比算指标少。
1. 报表分三层,各有名自的读者
日报看运营:昨日故障单数、平均响应、平均修复时长、停机合计,给设备主管;月报看趋势:MTBF/MTTR 月度曲线、故障 TOP 设备、改善项进展,给厂长;季度报看决策:维修费与残值比、大修更换建议清单,给经营层。三层报表的口径必须同源,都从工单系统自动取数,不要人工拼——手拼的报表会消耗掉指标体系好不容易攒下的公信力。
2. 考核只考团队,不考个人
把 MTTR 考到机修个人头上,收获的一定是拖单和不接单;把 MTBF 考到设备主管头上,收获的可能是隐瞒不报。更稳妥的做法:考核班组整体的响应及时率和一次修复率,MTBF 只进改善会议不进考核表。数据用来照亮问题,不用来制造对抗。
3. 给指标设一段「观察期」
新指标上线前三个月只看不考,让所有人知道数据在积累、口径在稳定。观察期还有一个隐藏作用:让真正干活多的人先看到自己的数据被公平记录,后面的考核推行才有群众基础。
常见问题解答
Q1:MTBF和MTTR分别怎么计算?
MTBF=总运行时长÷故障次数,衡量设备多久坏一次;MTTR=故障停机总时长÷故障次数,衡量坏了多久修好。前提是先统一定义:什么算故障、停机从故障确认时刻起算、到验收通过时刻截止,口径不统一算出的指标没有意义。
Q2:停机损失怎么核算比较合理?
停机损失=停机时长×单位时间产值贡献+废品损失+加班赶工成本+可能的延期赔付,不能只算维修费。单位时间产值贡献建议用近12个月产值÷有效工时估算,各厂口径自定,关键是算账逻辑前后一致,趋势才可比。
Q3:数据采集要多久才能做分析?
连续采集4周即可形成基线,足以支撑MTBF排行和改善项排序。要做大修更换这类重决策,建议积累3个月以上。基线期承诺数据不用于考核,真实比完整更重要。
Q4:MTBF排行榜会不会变成追责工具?
取决于管理层的用法。榜单用来找设备问题(保养策略、备件、寿命),不点名批评人;一旦变成批斗榜,一线会学会瞒报,数据质量立刻崩塌。建议榜单只进设备改善会,不进个人绩效会。
Q5:机修班组会抵触这套指标吗?
前期观望是正常的,但响应时长、一次修复率有据可查后,老师傅往往是最大受益者——干得好终于看得见。过渡的关键是基线期不追责,考核引入前先让班组参与规则制定。
Q6:这套方法适合什么规模的企业?
设备百台以上、有专职机修的工厂最适合;小厂可以先只做扫码报修加MTTR统计,同样能解决响应慢和漏单问题。MTBF分析需要一定的故障数据量,设备太少的场景建议按季度拉通看趋势即可。